

Работа аналитика — находить закономерности в данных. С неопределёнными и неструктурированными данными делать это невозможно — они не подчиняются инструментам анализа и не позволяют обучать нейросети. Поэтому для работы аналитикам нужны уже подготовленные однозначные данные — датасеты.

Что такое датасет для анализа данных
Датасет (англ. dataset) — это набор данных, подготовленный для анализа или обучения моделей. Он может быть как полностью структурированным, например в виде таблицы, так и частично неструктурированным, например представлять собой коллекцию изображений, текстов или аудиофайлов. В датасете у каждого объекта есть конкретные свойства: признаки, связи между объектами или определённое место в выборке данных. Датасеты используют, чтобы строить на основе данных гипотезы, делать выводы или обучать нейросети.
Для примера возьмём набор фотографий разных животных. Сам по себе этот набор — просто массив данных, его невозможно использовать для аналитики или обучения нейросети. Чтобы он стал датасетом, в нём должно быть однозначно прописано, какое конкретно животное изображено на фотографии и по каким признакам оно отличается от других животных.

Примитивно датасет можно представить в виде группировки по признакам
Данные в датасете могут быть разные, например:
- статистика покупок в магазине;
- географическое расположение офисов;
- демографические признаки населения;
- соответствие звуков аудиотексту;
- заболевания с конкретными симптомами.
Данных в датасете должно быть достаточно много, особенно если для анализа используется несколько признаков. Если нейросети нужно отличать кошек от собак, попугаев, лошадей и рыб, то сотни объектов для датасета обычно не хватит. Для классических моделей компьютерного зрения обычно требуются десятки тысяч размеченных примеров. Однако современные методы transfer learning и генеративные модели позволяют обучать прикладные решения на значительно меньших выборках. Если нужно спрогнозировать, что именно купит конкретный клиент, то понадобятся демографические данные и данные о покупках десятков тысяч других клиентов. Только так прогноз будет точным.
Два способа сбора датасета
● Вручную. Люди лично, без всякой автоматизации отсматривают объекты и описывают их признаки. Так создают обучающие датасеты из данных, которые изначально не структурированы. Например, именно так создают датасеты для распознавания изображений — люди смотрят фото и пишут, что конкретно на них изображено.
● Автоматически. Системы сбора информации сразу заполняют заранее подготовленную таблицу структурированными данными. Например, так можно собрать датасет о демографии клиентов магазина на основе анкеты, которую они заполняют на сайте.
На курсе Практикума «Аналитик данных» студенты учатся работать с датасетами: проверять их, анализировать и использовать в моделях машинного обучения.


Из чего состоит датасет
Датасет состоит из двух основных компонентов:
- Объект: фото, фрагмент аудио, покупатель, заболевание, название офиса.
- Характеристики объекта: конкретные признаки, связи с другими объектами, его местоположение.
Характеристики объекта обычно задают не словами, а цифрами. Например, нужно отметить пол покупателя. Это делают не буквами «М» и «Ж», а создают два признака «Мужской» и «Женский», и один могут обозначить как 0, а другой как 1.
Именно поэтому признаки часто могут иметь нулевые значения, и иногда их даже больше, чем единичных. Например, у нас есть человек и 100 вариантов городов, где он родился. Только в одном городе может стоять единица — а во всех остальных будут нули. Получается, что большая часть датасета часто пустая, и это нормально.
Есть и другие методы представления категориальных признаков.
- Порядковое кодирование. Категориям присваивают числа по заданному порядку. Например, уровню образования можно задать значения: школа — 1, колледж — 2, вуз — 3.
- Эмбеддинг. Категории преобразуют в набор числовых параметров, которые модель подбирает автоматически. Например, в рекомендательной системе товары одного типа могут получить похожие числовые представления.
Выбор метода зависит от задачи, объёма данных и используемой модели.
Чем больше в датасете для обучения объектов, тем лучше он отражает реальность, и тем более достоверной получается аналитика и обученные с её помощью нейросети.
Чем больше в датасете характеристик, тем он сложнее для анализа. Это даже называют «проклятием размерности». С ростом количества признаков сложность обработки датасета растёт не линейно, а по экспоненте, то есть очень быстро.
Материал по теме:
Для чего строят и обучают нейросети в IT

Виды датасетов
1. Простая запись
Это таблица, в строках которой расположены объекты, а в колонках — признаки. Явных связей между строками и столбцами нет, признаки просто соответствуют конкретным объектам. Чаще всего датасеты выглядят именно так.
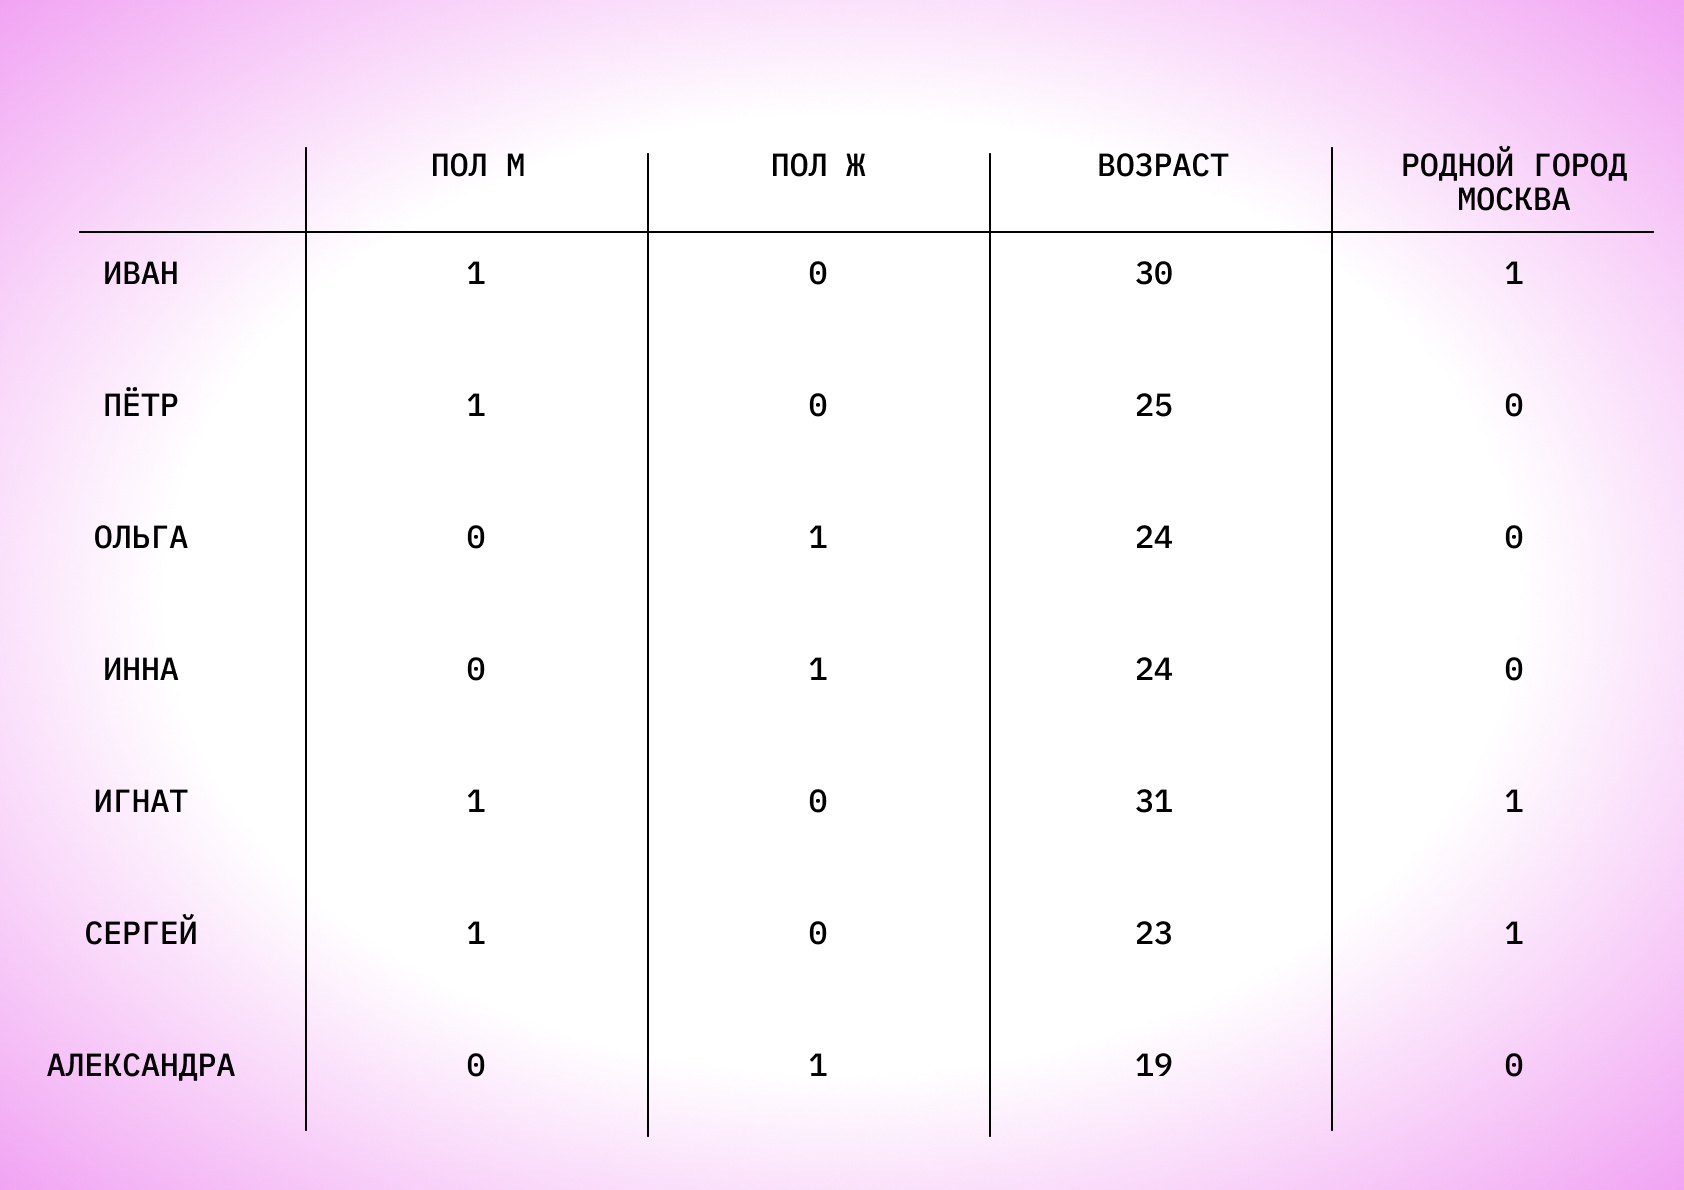
Так может выглядеть фрагмент датасета в формате простой записи

2. Граф
Данные о связях между объектами, которые могут быть представлены визуально в виде схемы из объектов, соединённых стрелками. А могут быть в виде таблицы, где в строках и колонках указаны объекты, а в пересечениях — связи между ними.
Графы бывают структурированные и неструктурированные. У первых присутствуют либо отсутствуют соотношения между объектами. У вторых они могут быть направленные — например, первый объект соотносится со вторым, а второй с первым уже нет. Кроме того, у соотношений может быть разный вес. Например, первый объект отправил второму 10 сообщений — тогда вес этого соотношения равен 10.

Структурированный граф пользователей социальной сети в виде визуальной схемы
3. Упорядоченные записи
Здесь роль играет не соотношение объектов или их признаки, а конкретное расположение в таблице с данными, пространстве или времени.
Например, такой датасет для анализа данных может быть в виде таблицы, в которой главная информация — это расположение объекта.
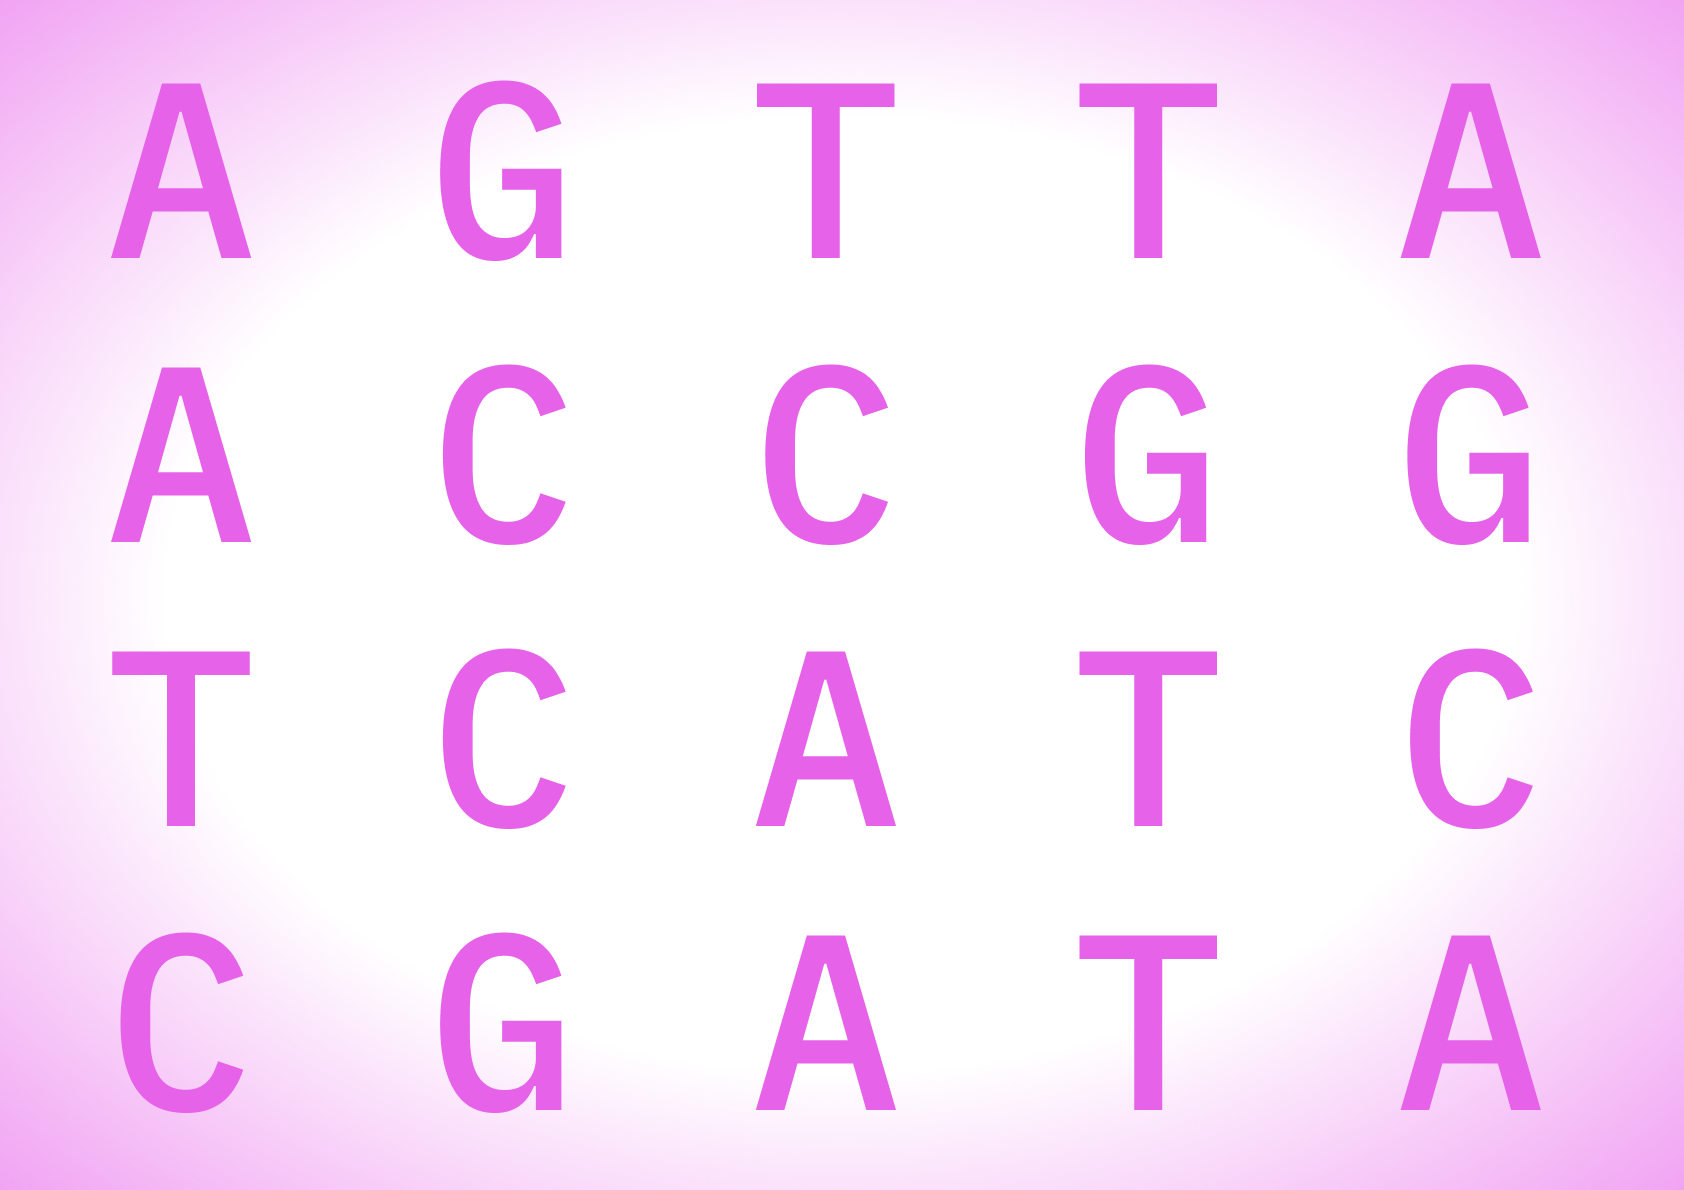
Пример такого датасета — геном, где важно расположение каждого конкретного гена
Где искать датасеты
Один из инструментов для поиска открытых наборов данных — Google Dataset Search. Также датасеты часто публикуют на специализированных платформах и в репозиториях — например, на Kaggle, в каталогах Hugging Face или на GitHub.
Примеры датасетов, открытых для использования
- World Bank Open Data. Наборы данных о демографии и экономических показателях.
- IMF Data. Датасеты о финансах и ценах на товары.
- Google Trends. Данные о поисковой статистике и трендовых запросах.
- xView. Большой набор воздушных снимков Земли с аннотациями.
- Labelme. Большой датасет с уже размеченными изображениями.
- HotspotQA Dataset . Датасет с вопросами-ответами для генерации ответов на часто задаваемые простые вопросы.
- MIMIC-III. Обезличенные медицинские данные пациентов.
- CREMA-D — датасет для распознавания эмоций по записи голоса.
Часто бывает так, что датасета по конкретному запросу не существует. Например, если речь про список клиентов конкретного магазина. В таком случае датасет может предоставить компания, либо его придется формировать самостоятельно: собирать данные и очищать их вручную или автоматически. Часто такие задачи отдают на аутсорс — есть компании, которая занимается подготовкой датасетов из сырых данных.
Совет от эксперта
Подпишитесь на наш ежемесячный дайджест статей —
а мы подарим вам полезную книгу про обучение!


Читать также:

